Nesse texto, mostraremos uma das diferentes formas de se acessar os microdados da Pesquisa Nacional por Amostra de Domicílios Contínua (PNAD-C) [https://www.ibge.gov.br/estatisticas/sociais/trabalho/9171-pesquisa-nacional-por-amostra-de-domicilios-continua-mensal.html?=&t=microdados]. Primeiramente, é importante ressaltar que o primeiro passo para se utilizar os microdados da PNAD-C, ou de qualquer outra pesquisa, é se perguntar se é realmente necessário utilizar essa base de dados para obter a informação que você deseja. O Sistema IBGE de Recuperação Automática (SIDRA) [https://sidra.ibge.gov.br/home/ipca/brasil], por exemplo, disponibiliza uma série de estatísticas descritivas com níveis de desagregação ajustáveis para os usuários.
Os dados do SIDRA, no entanto, são limitados quanto às combinações das variáveis para comparações ou seleção de casos específicos de interesse. Apesar de ser possível realizar análises descritivas simples, essas bases de dados não permitem a realização de testes de estatística inferencial que possam estabelecer comparações estatisticamente significativas entre grupos ou amostras de anos diferentes. Uma vez que os microdados disponibilizam as informações ao nível dos indivíduos, devidamente desidentificados, se abre um leque de possibilidades quanto às análises estatísticas possíveis de se realizar. Por enquanto, vamos nos ater a como acessar a base de microdados da PNAD-C.
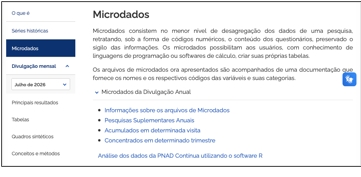
No link acima, que leva aos microdados da PNAD-C, você verá que há uma seção de dados de divulgação anual, na qual os dados estão disponibilizados como “acumulados em determinada visita” ou “concentrados em determinado trimestre”. Em termos gerais, quando queremos obter as informações mais gerais e em mais detalhes da população brasileira, para cada ano, utilizamos os dados acumulados na visita 1. Isso se deve ao fato de a primeira visita, dentre as cinco que cada domicílio recebe, é aquela que concentra o maior número de informações e que possui a maior taxa de resposta. A única exceção para essa regra são os anos da pandemia, de 2020 e 2021, que possuem uma taxa de resposta menor e concentram mais informações nos dados acumulados da quinta visita. O tópico “Pesquisas Suplementares Anuais” leva a uma tabela, atualizada de forma contínua, que mostra se um determinado tópico é abordado em uma visita ou em um trimestre específico. Tópicos abordados em trimestres específicos são aqueles afetados pelo calendário anual, como por exemplo a Educação, que é sempre investigada no segundo trimestre, quando as matrículas escolares não serão afetadas pela passagem de um ano para o outro.
Em cada trimestre da coleta de dados da PNAD-C, cada quinta parte dos domicílios da amostra se encontra em uma das cinco visitas. Ou seja, a cada trimestre, 20% dos domicílios é substituído por um novo conjunto de domicílios e ficará ao menos um ano sem poder ser sorteado novamente para a amostra. A diferença entre os dados acumulados por trimestre e por visita deve ser considerada quando a intenção é pesquisar tópicos específicos que são investigados nas pesquisas suplementares.
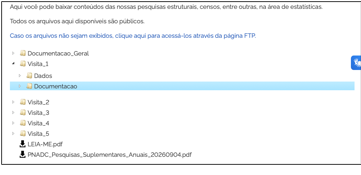
Ao clicar em “Acumulados por determinada visita”, você encontrará uma página que possui os dados e documentação para cada visita de cada ano do qual esses dados e documentação estão disponíveis. De modo análogo, o mesmo pode ser feito para os microdados “Concentrados em determinado trimestre”. É possível fazer o download dos microdados, que juntamente com os arquivos de input que estão na documentação, permitem a leitura das bases sem a necessidade de se conectar com a internet. Para os fins desse tutorial, no entanto, nós nos ateremos a demonstrar o acesso aos microdados por meio do pacote PNADcIBGE que opera na linguagem de operação R, a qual recomendamos ser utilizada por sua interface RStudio. Ainda assim, é importante conhecer esse caminho das bases de microdados porque é justamente na documentação da respectiva base, seja acumulada por visita ou concentrada em trimestre, que você encontra o dicionário das bases de dados, documento essencial para compreender as possibilidades e limites analíticos da base de dados utilizada.
O uso do pacote PNADcIBGE, por meio da interface RStudio, possui algumas vantagens em relação ao download direto dos arquivos de microdados. A primeira é que a base que será baixada sempre será a versão mais atualizada disponibilizada pelo IBGE. Isso é particularmente útil, pois frequentemente as bases de dados passam por revisões e correções quanto às variáveis e projeções populacionais. Uma vez que é desejável construir uma análise que seja replicável, utilizar um banco de dados datado pode impossibilitar a replicação exata de seus resultados. Além disso, o pacote é utilizado pelo corpo técnico do IBGE para produzir as estatísticas descritivas do SIDRA, o que dá maior confiabilidade na qualidade dos dados obtidos. Isso não significa dizer que outros softwares não são recomendados, sendo que muitos, inclusive, desempenham certas funções analíticas de forma mais conveniente ou precisa do que a linguagem R. No entanto, a linguagem R e o RStudio são recursos analíticos completamente gratuitos e amplamente utilizados.
Acessando os microdados da PNAD-C por meio da linguagem R
Para acessar a base de dados, por meio do pacote PNADcIBGE, basta utilizar o comando get_pnadc, definindo corretamente os argumentos.
Instalar e carregar o pacote PNADcIBGE
install.packages(“PNADcIBGE”, dep = T)
require(PNADcIBGE)
Carregando a base acumulada por visita
base_dados <- get_pnadc(year = 2023,
interview = 1,
labels = F,
deflator = F)
Carregando a base concentrada por trimestre
base_dados <- get_pnadc(year = 2023,
topic = 2,
labels = F,
deflator = F)
Vamos observar o que cada argumento significa: ‘year’ é o argumento para indicar o ano de referência; ‘interview’ é utilizado para indicar o número da visita e ‘topic’ para indicar o trimestre, repare que se deve optar por um dos dois; ‘labels’ é um argumento que define se o valor das variáveis aparecerá codificado ou em forma de texto; e ‘deflator’ define se os valores monetários serão apresentados em seu valor nominal (como foram coletados) ou se estarão deflacionados (corrigidos de acordo com um índice específico). A vantagem de se deixar os rótulos (labels) desativados é reduzir o custo computacional e facilitar a manipulação das bases de dados. Por isso, é essencial fazer o download do dicionário correspondente ao trimestre/visita e ano da base de dados. A ativação do deflator depende do propósito de quem utiliza a base de dados, sendo uma questão de preferência entre definir pessoalmente os critérios de correção dos valores nominais, ou não.